Un PC, douze machines, un SOC complet
SocForge est un laboratoire SOC complet construit avec VirtualBox sur un seul ordinateur. Chaque détection y a été déclenchée par une action offensive réelle et bénigne — lancée depuis une machine Kali ou, pour les techniques locales, sur l'hôte visé — puis observée dans le SIEM et documentée avec ses journaux, ses horodatages UTC et ses captures. Rien n'est affirmé sans une capture à l'appui.
35 secondes : une attaque, suivie jusqu'au bout
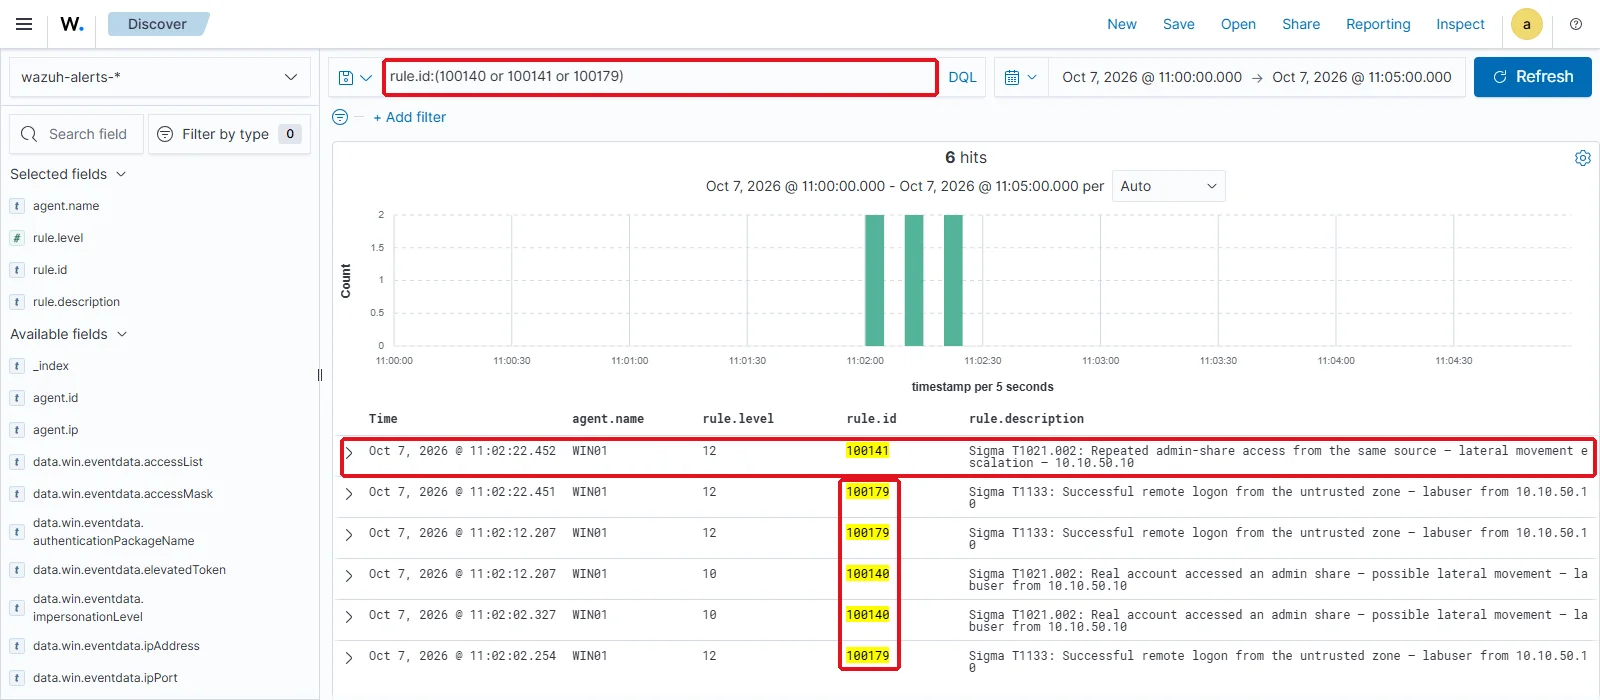
Le 7 octobre 2026, une seule attaque a été suivie sur toute la chaîne. Depuis la machine Kali, trois accès au partage d'administration d'un poste Windows 11 avec un compte local valide. Wazuh signale la session venue de la zone non fiable 7 secondes après la première connexion, puis escalade au troisième accès. À partir du moment où cette alerte est remise à l'orchestrateur, la suite se déroule sans intervention humaine :
- 0 sAlerte Wazuh 100141 remise à Shuffle
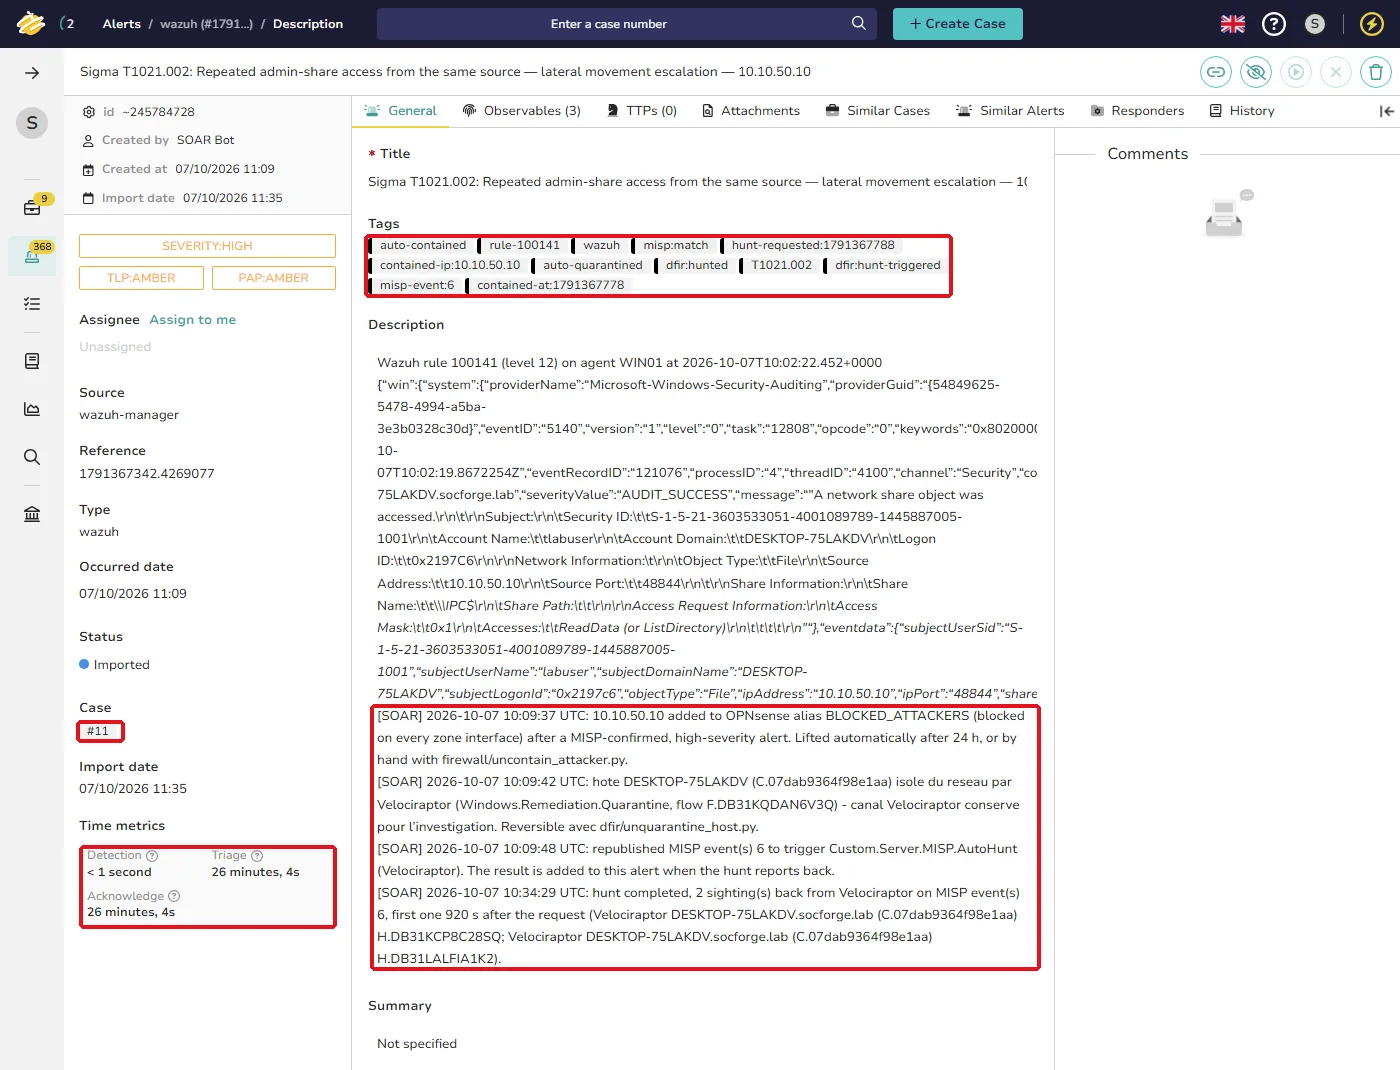
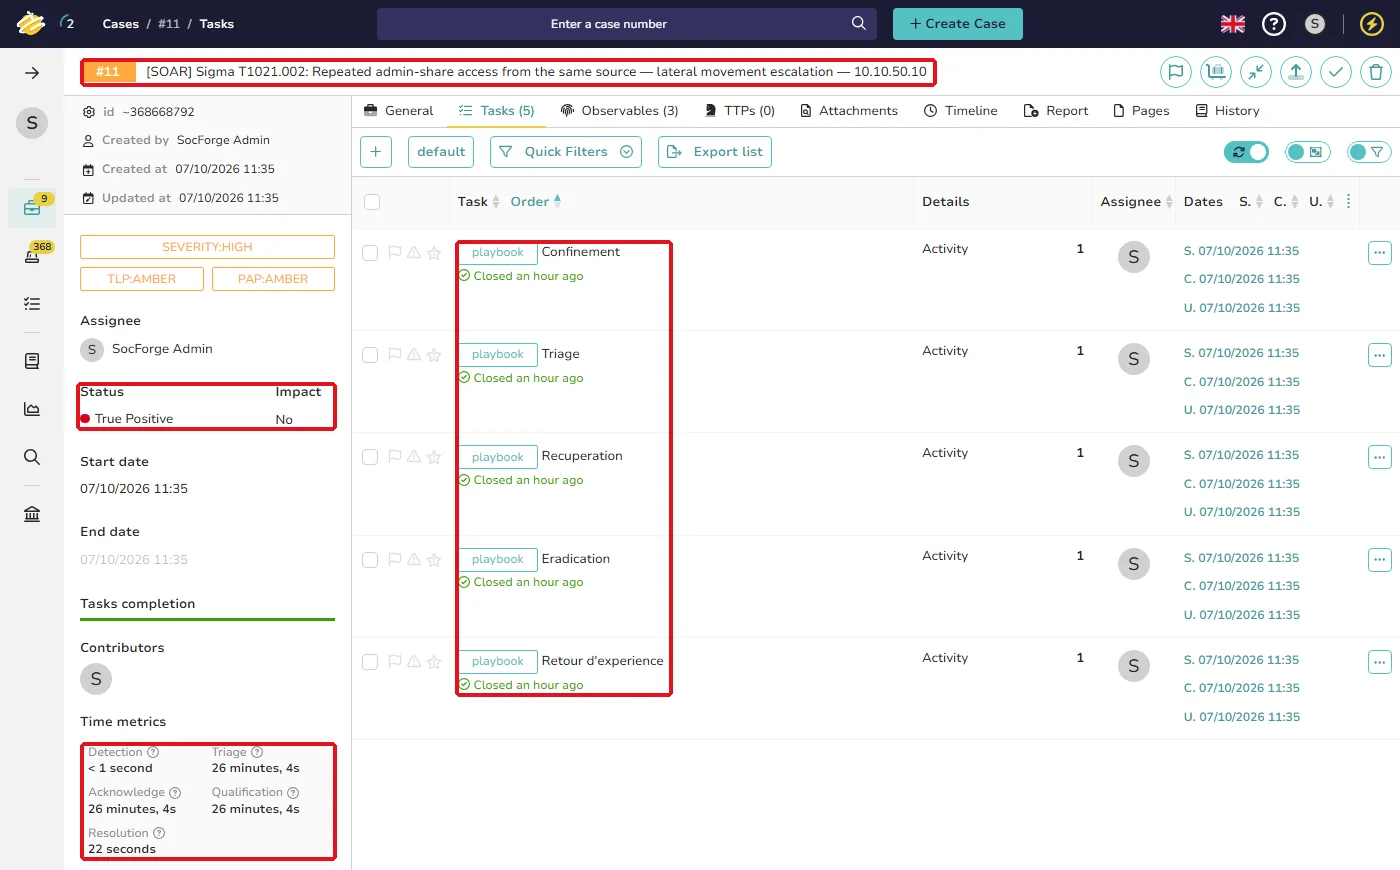
- 7 sAlerte créée dans TheHive, avec ses observables
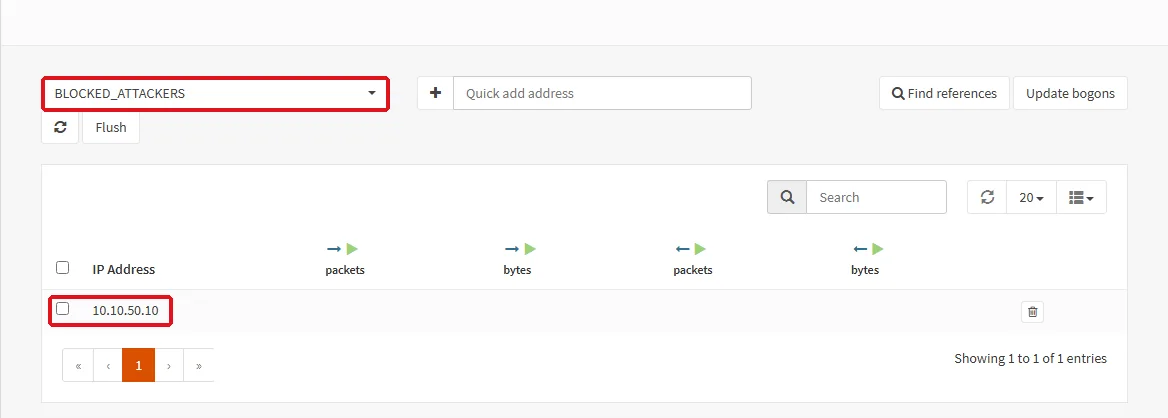
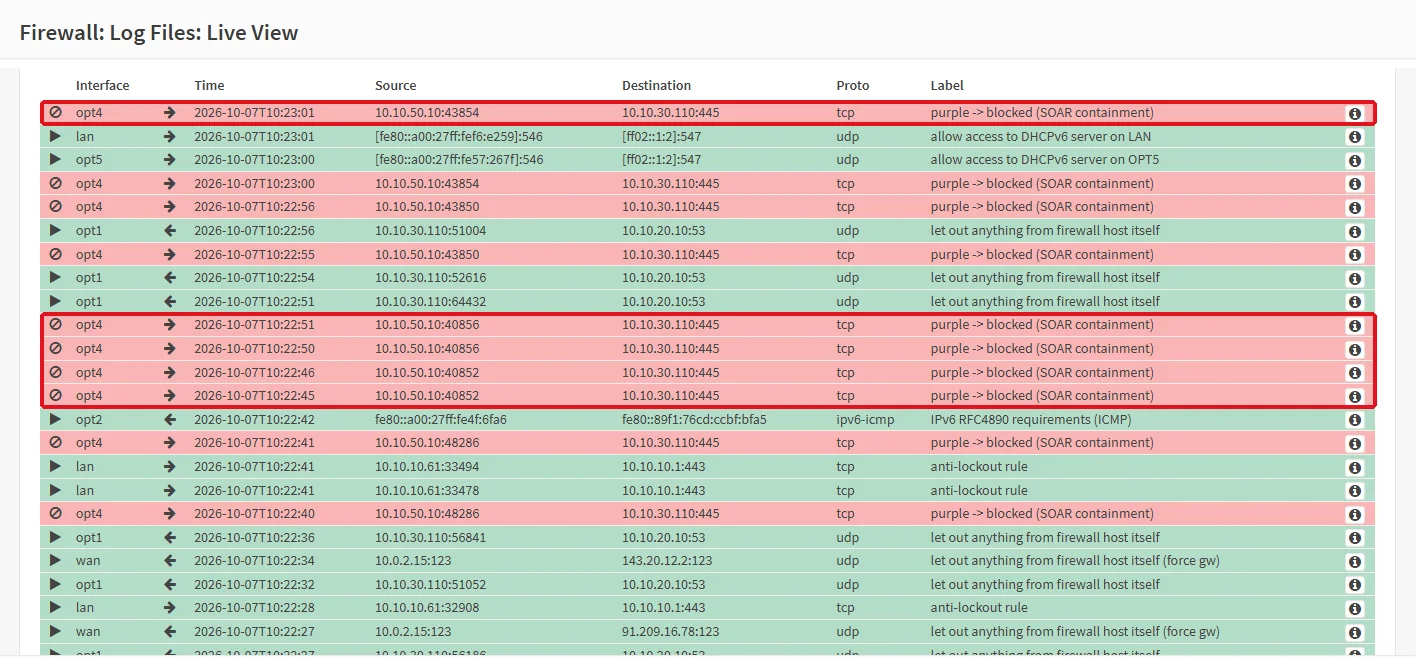
- 24 sAdresse de l'attaquant bloquée sur le pare-feu OPNsense
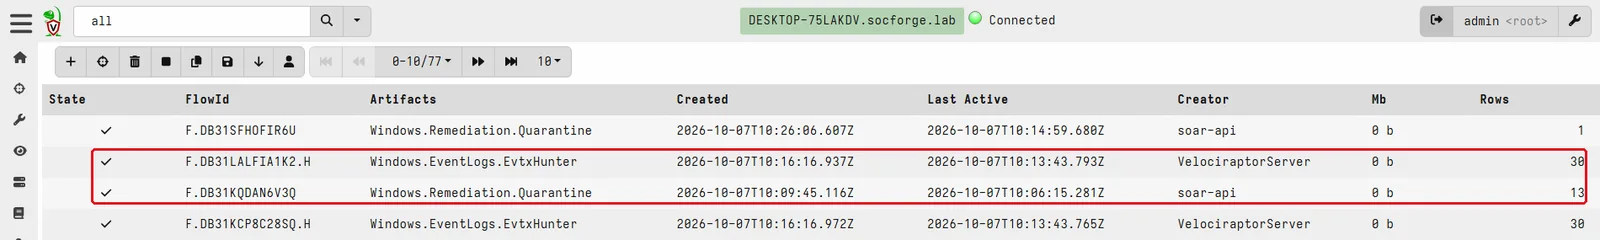
- 29 sOrdre d'isolement envoyé à l'hôte via Velociraptor
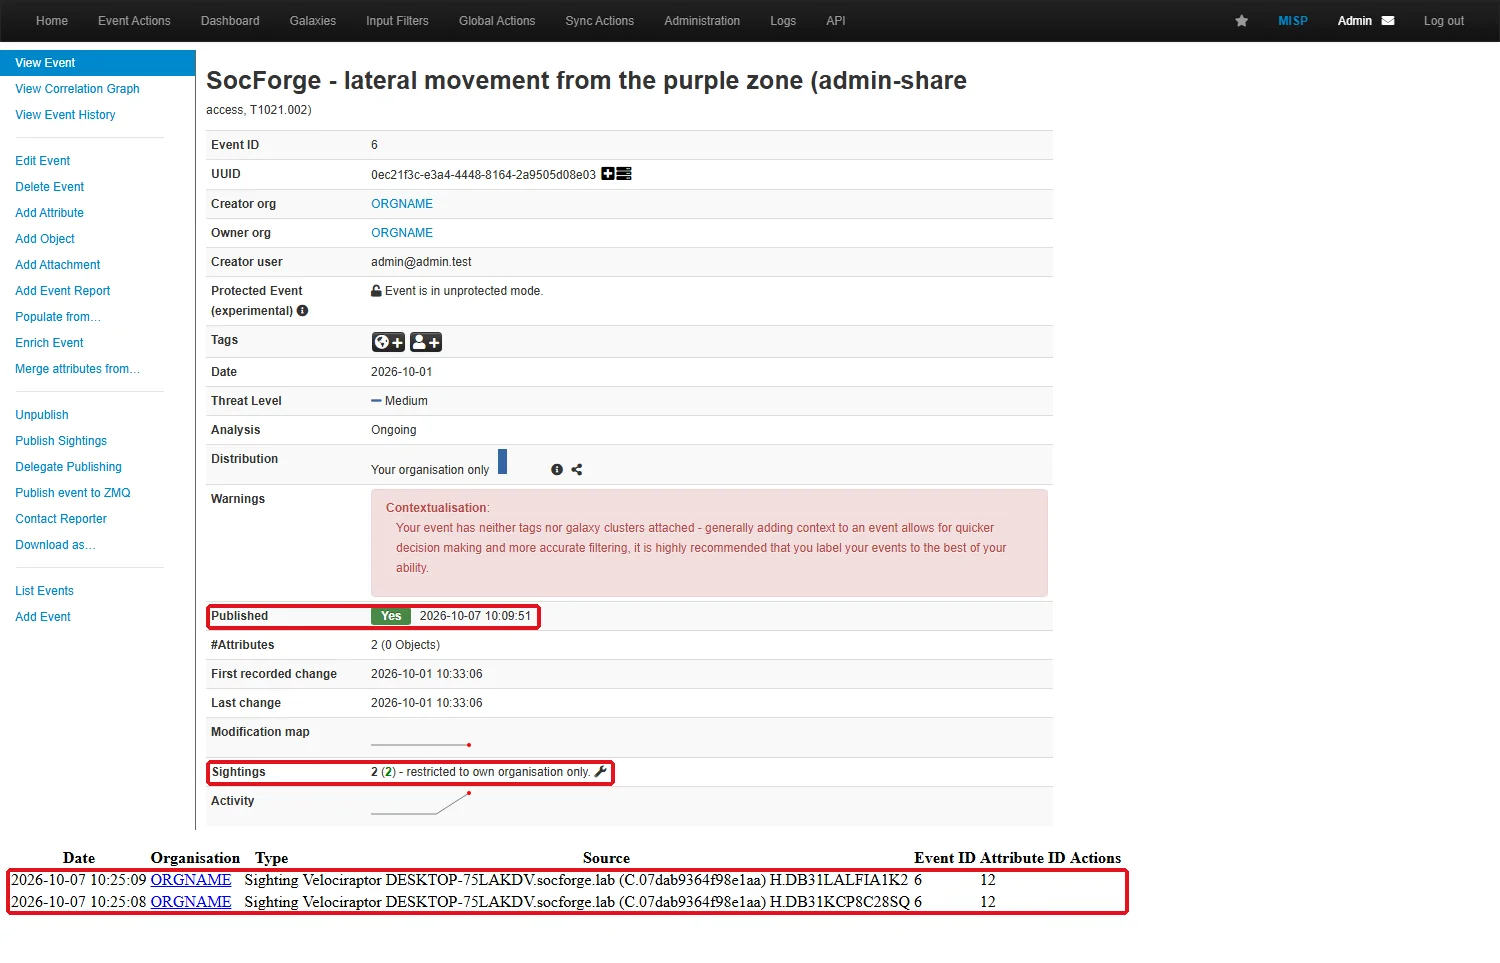
- 35 sChasse demandée à partir de l'événement MISP concerné
Ce sont les temps d'une seule attaque simulée en laboratoire, avec automatisation. Ce n'est pas une référence pour un SOC de production. Le lab tourne aussi sur un PC de 16 Go : les machines sont donc démarrées par groupes, et l'alerte réelle a été remise à Shuffle quelques minutes après sa levée, avec le script d'intégration officiel de Wazuh. La chaîne et sa configuration sont les mêmes que sur un hôte plus puissant ; seule la séquence est découpée.
Architecture
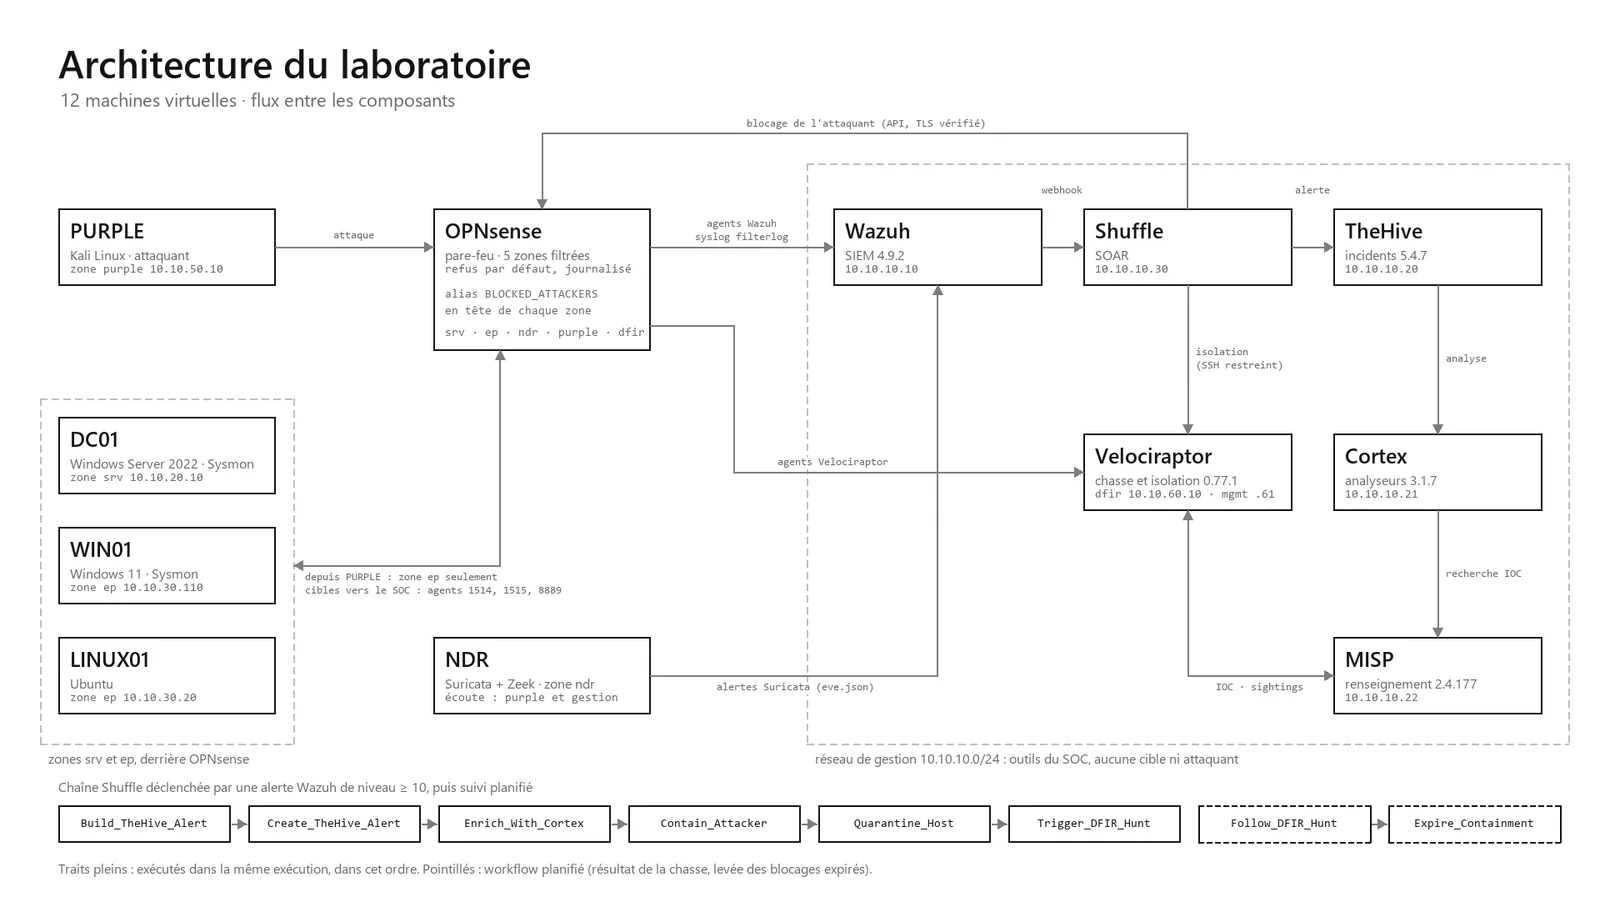
| Couche | Composants | Rôle |
|---|---|---|
| Attaque | PURPLE (Kali Linux) | Lance les attaques, seule dans sa zone |
| Réseau | OPNsense · Suricata · Zeek | Segmentation en refus par défaut et détection réseau passive |
| Cibles | DC01 · WIN01 · LINUX01 | Domaine Windows, poste Windows 11 avec Sysmon, serveur Ubuntu — chacun avec un agent Wazuh |
| Détection | Wazuh | Reçoit les agents, le syslog du pare-feu et les alertes réseau |
| Réponse | Shuffle · TheHive · Cortex · MISP | Orchestration, suivi d'incident, analyse, renseignement sur les menaces |
| DFIR | Velociraptor | Chasse sur les endpoints et isolement d'un hôte compromis |
Étape 1 — Collecter, et vérifier que tout arrive
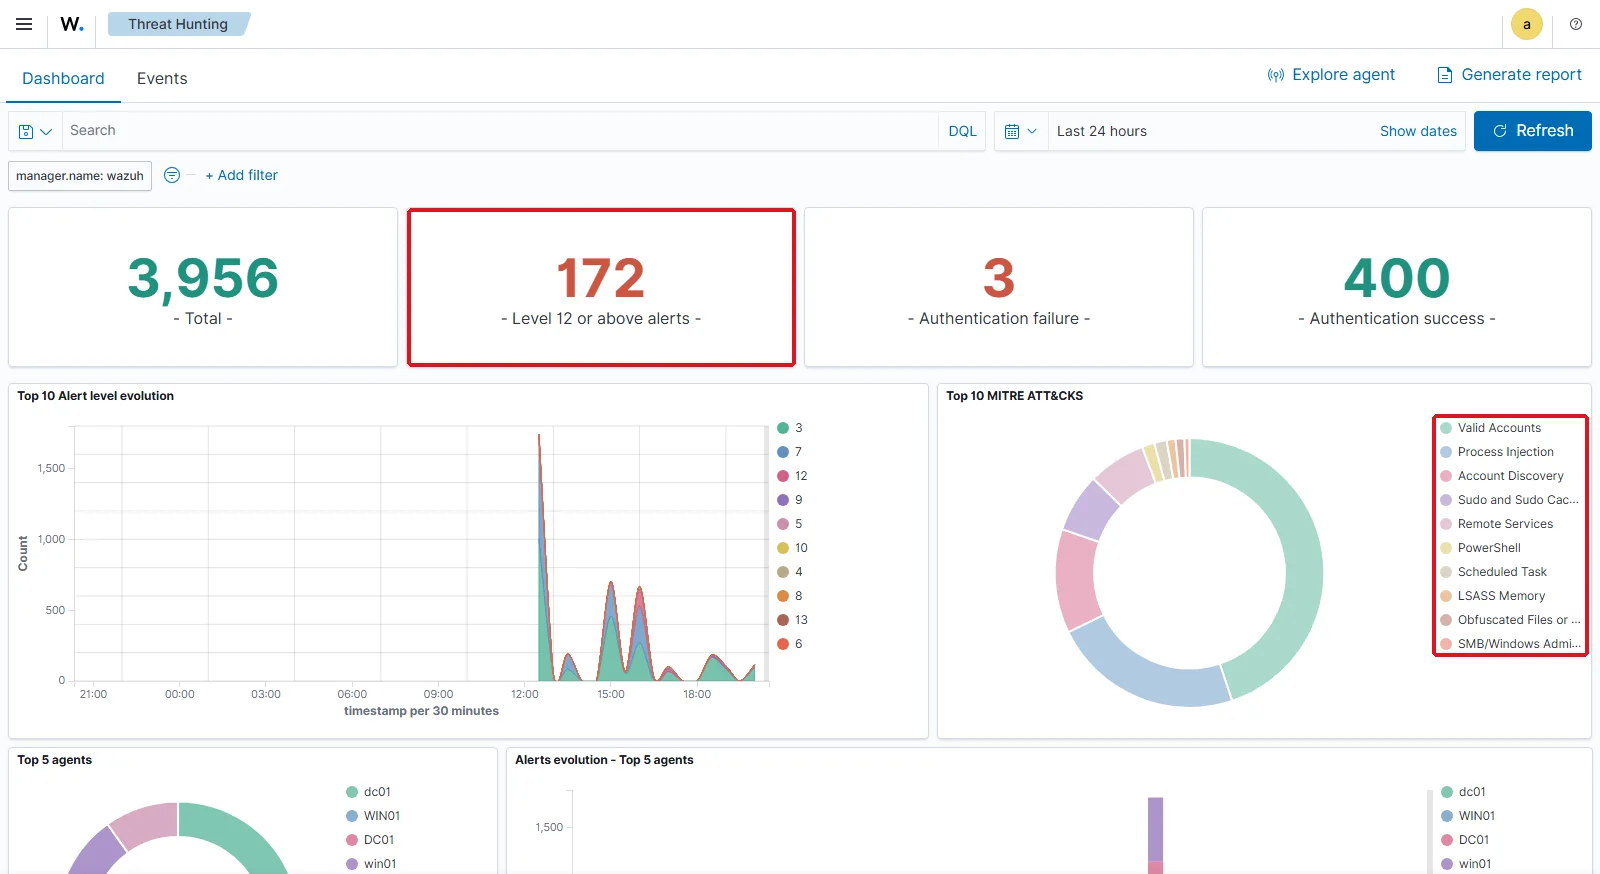
Avant d'écrire la moindre règle, il fallait confirmer que chaque source atteignait le manager : journaux Security, PowerShell et Sysmon sous Windows ; journaux d'authentification et surveillance d'intégrité en temps réel de /etc/cron.d sous Linux ; journal du pare-feu en syslog. Après une journée de tests, le tableau de bord Threat Hunting affiche 3 956 alertes en 24 heures, dont 172 de niveau 12 ou plus, avec une répartition ATT&CK conforme aux techniques réellement exécutées.
Étape 2 — Détecter, et corriger la règle quand elle ne se déclenche pas
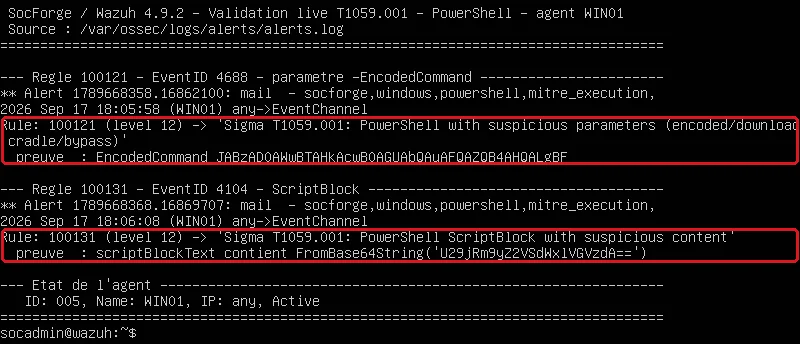
Chaque technique suit la même méthode : exécuter une action réelle et bénigne, vérifier si la règle se déclenche, la corriger sinon, puis conserver la preuve. Onze scénarios sur les hôtes couvrent les tâches planifiées, les comptes valides, les partages d'administration, PowerShell encodé, les scans de ports, la force brute SMB, sudo et cron sous Linux, le mouvement latéral, la persistance par clé Run, l'injection de processus et l'accès à LSASS. Quatre d'entre eux m'ont appris plus que les autres.
Partages d'administration : séparer le bruit du signal
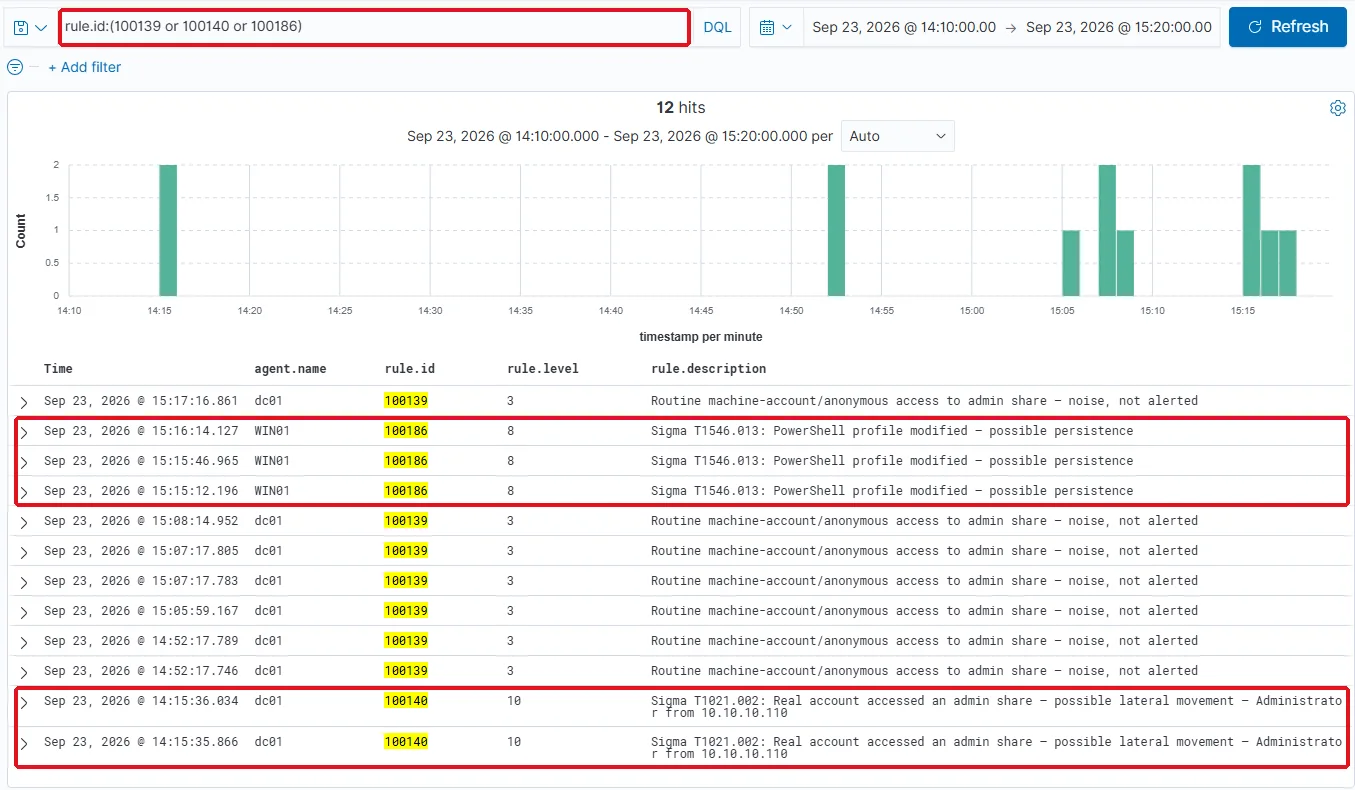
Un contrôleur de domaine accède en permanence à ses propres partages avec des comptes machine. Alerter sur chaque accès à C$ ou ADMIN$ noierait l'analyste. La règle 100139 classe ces accès de routine au niveau 3, sans alerte ; la règle 100140 ne garde que les accès faits par un vrai compte, au niveau 10.
La clé Run qui ne déclenchait rien
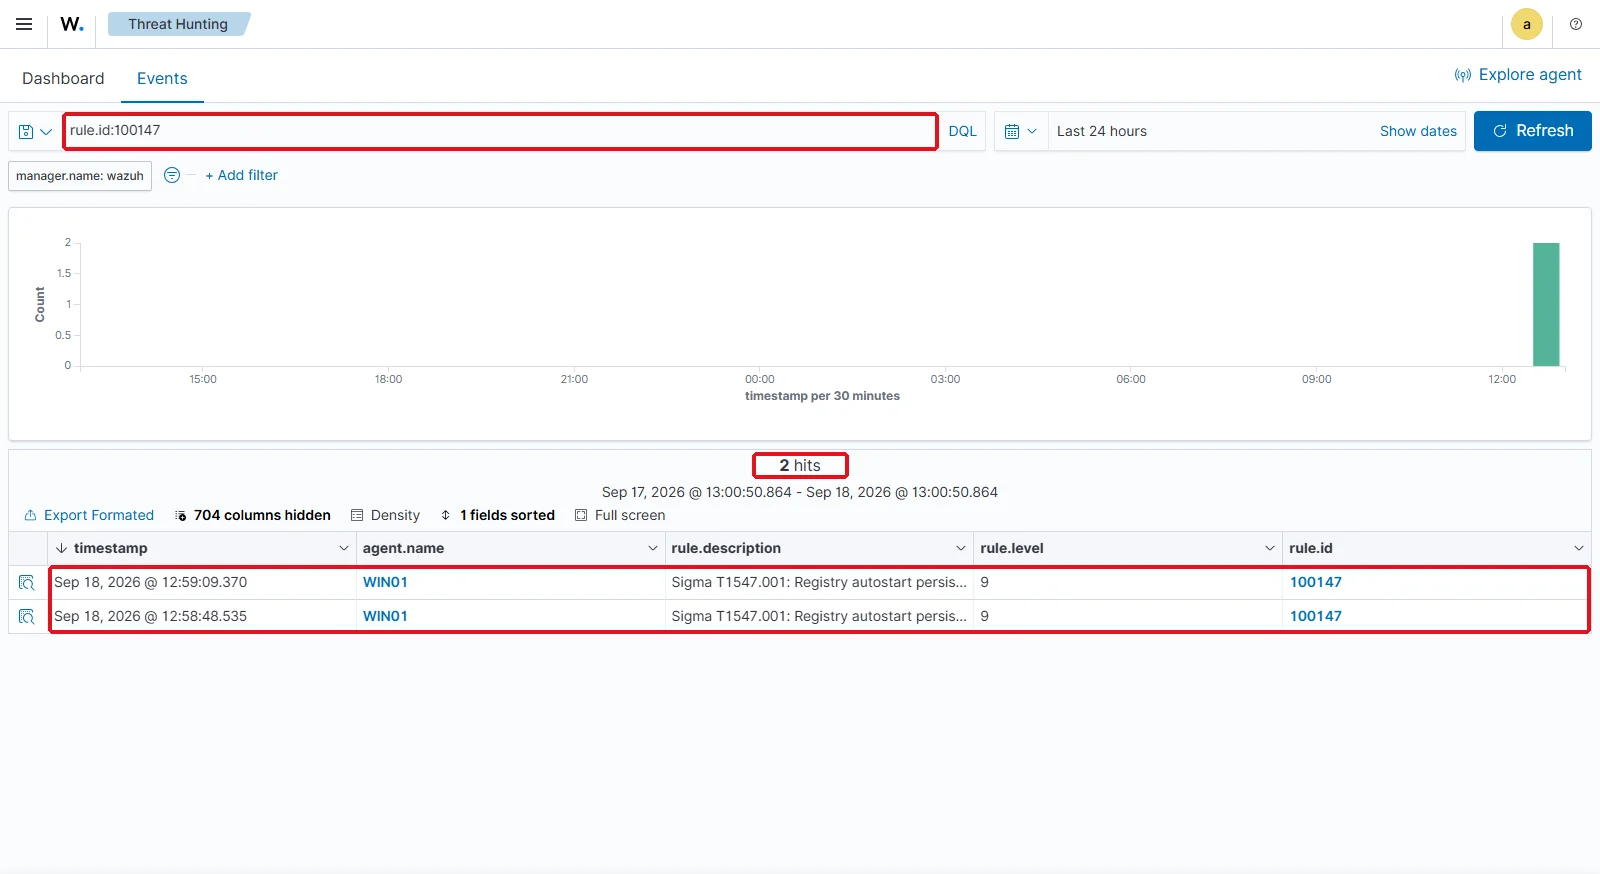
Une valeur est écrite sous CurrentVersion\Run ; Sysmon journalise l'écriture (événement 13) et la règle 100147 devait alerter au niveau 9. Elle ne le faisait pas. C'est la règle qui a demandé le plus d'investigation : elle restait muette tant qu'elle était chaînée avec if_group, et se déclenche depuis qu'elle l'est avec if_sid.
Injection de processus : 16 alertes sur 18 étaient un Ctrl+C
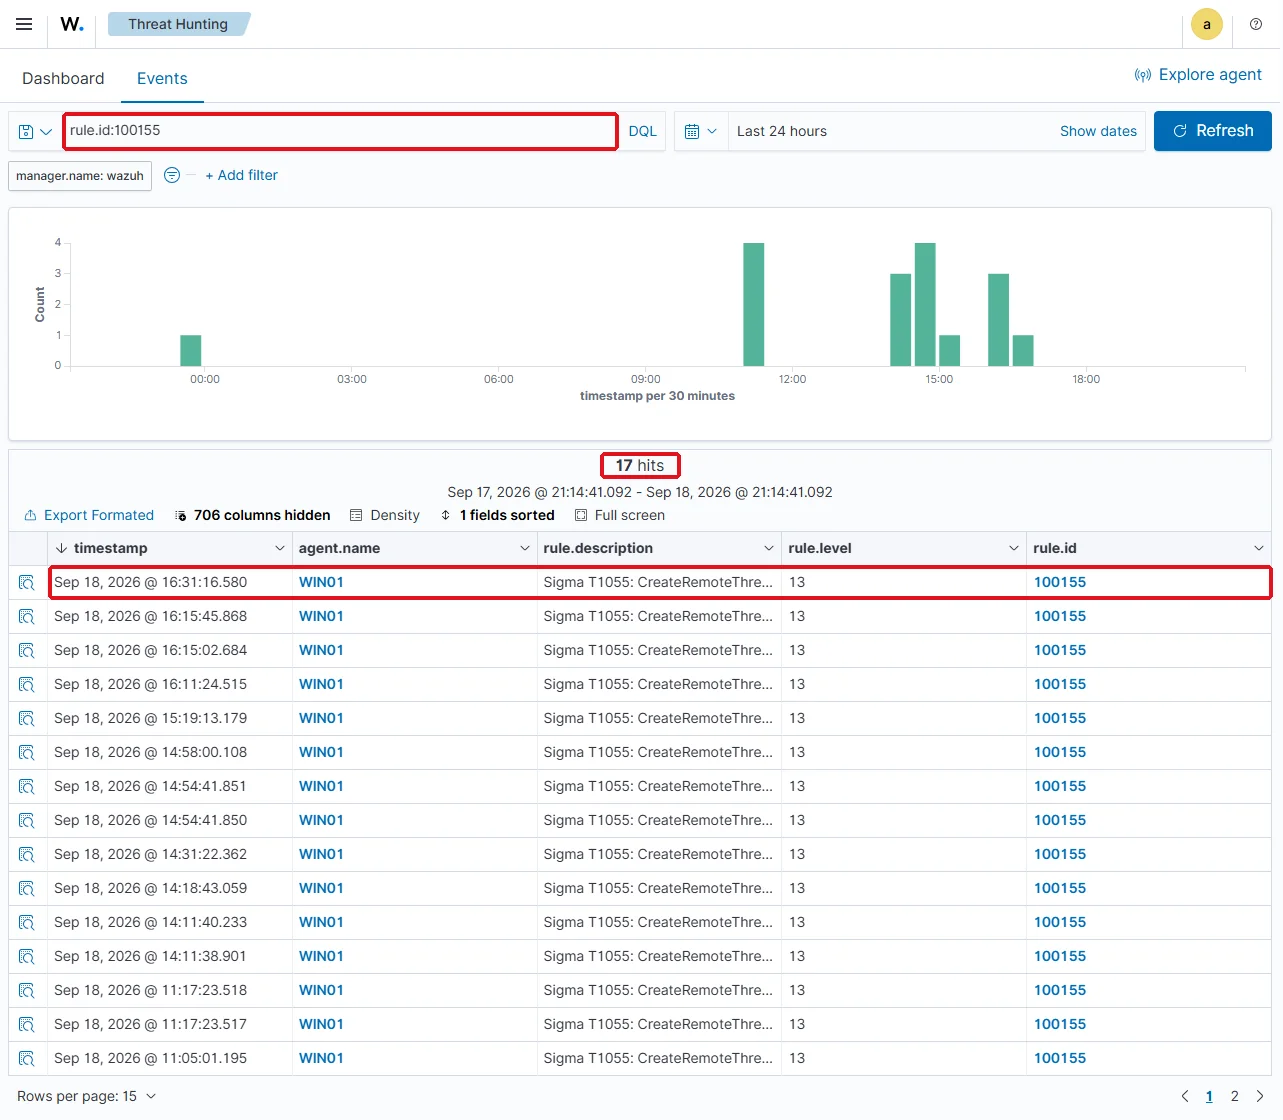
Un script crée un thread dans un notepad.exe local avec CreateRemoteThread. Sysmon produit l'événement 8 et la règle 100155 alerte au niveau 13 — dix-sept fois pour un seul test. L'analyse du bruit a montré que 16 des 18 alertes conservées par le manager étaient le signal Ctrl+C que Windows envoie aux programmes console. La règle 100156 classe désormais ce cas au niveau 3, sans alerte.
LSASS : quand la défense fonctionne, il n'y a rien à détecter
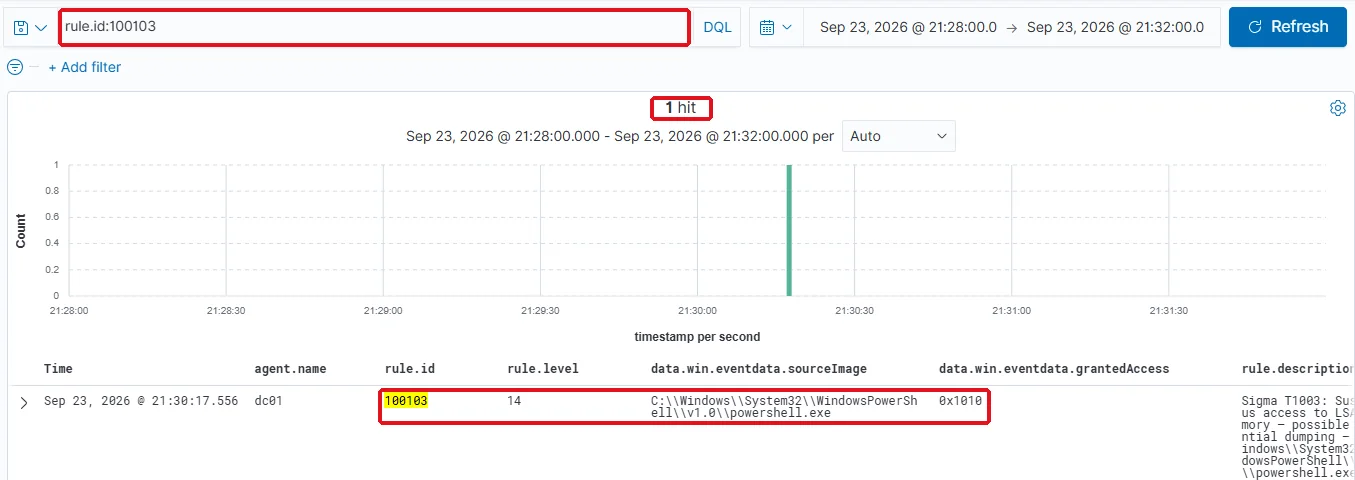
Sur WIN01, la protection LSA de Windows refuse l'ouverture de lsass.exe avant même que Sysmon ne la voie. Sur DC01, où cette protection n'est pas activée, l'accès est accordé et la règle 100103 alerte au niveau 14, deux secondes après la tentative. Même technique, deux machines, deux résultats honnêtes — tous deux documentés.
| Scénario | Technique | Où |
|---|---|---|
| SC-01 | T1053.005 Tâche planifiée | DC01 |
| SC-02 | T1078 Compte valide, ouverture de session réseau | DC01 |
| SC-03 | T1021.002 Partages d'administration, filtrage du bruit | DC01 |
| SC-04 | T1059.001 PowerShell encodé | WIN01 |
| SC-05 | T1046 Scan de ports depuis Kali | PURPLE → DC01 |
| SC-06 | T1110 Force brute SMB | PURPLE → DC01 |
| SC-07 | T1548.003 / T1053.003 sudo et cron | LINUX01 |
| SC-08 | T1021.002 + T1078 Mouvement latéral | WIN01 → DC01 |
| SC-09 | T1547.001 Clé Run | WIN01 |
| SC-10 | T1055 Injection de processus | WIN01 |
| SC-11 | T1003 Accès à LSASS | WIN01 (bloqué) · DC01 (détecté) |
Étape 3 — Surveiller le réseau, puis le découper en zones
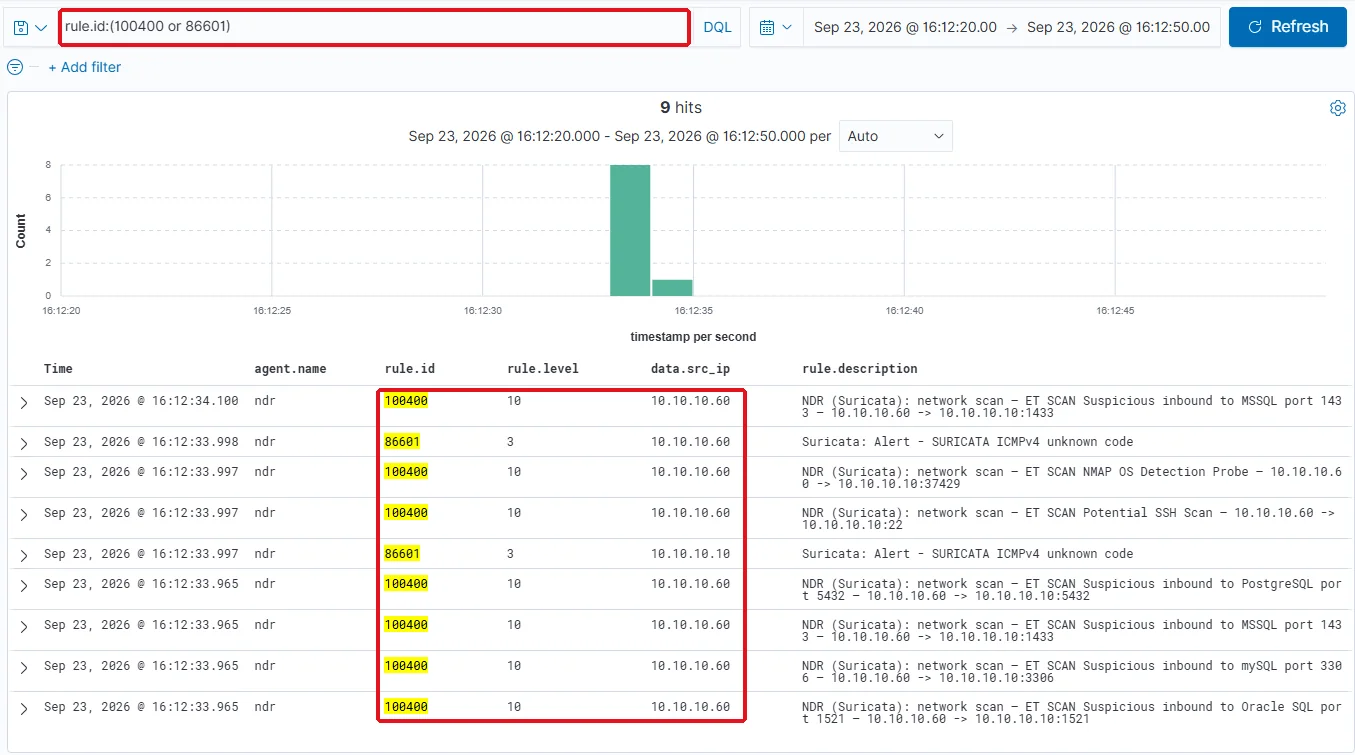
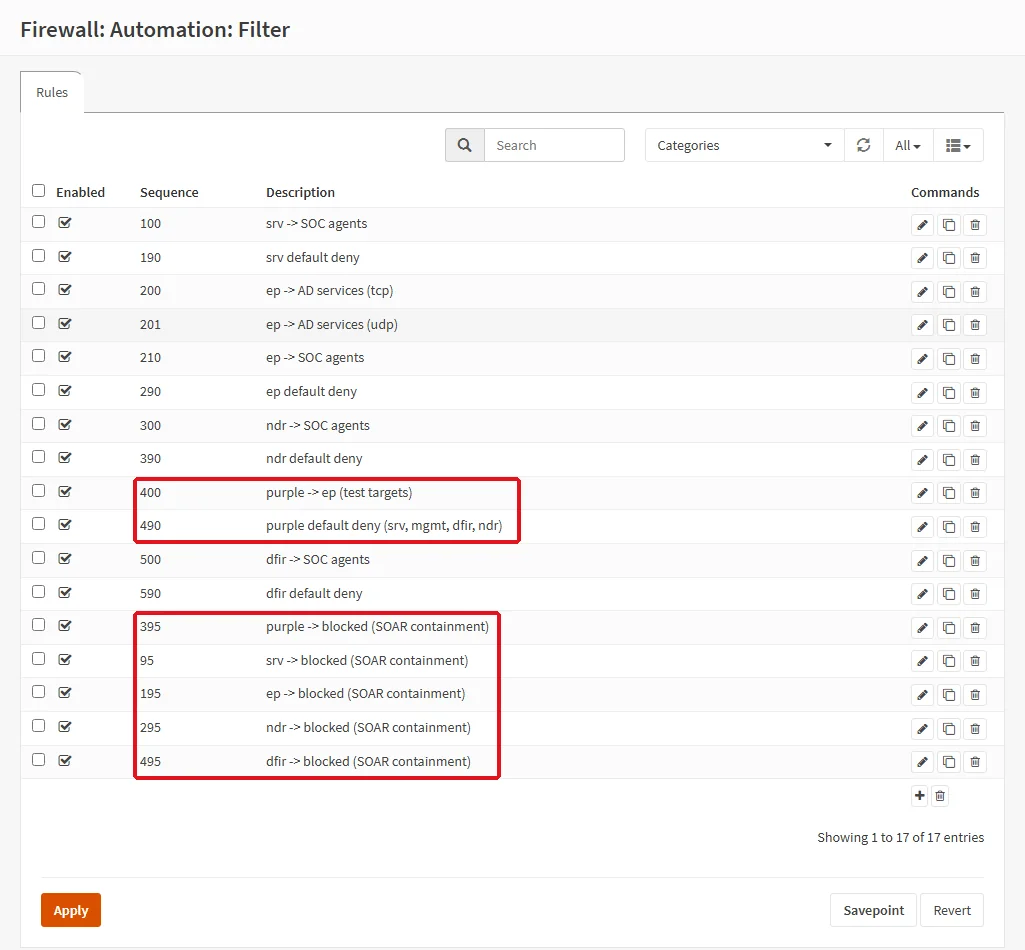
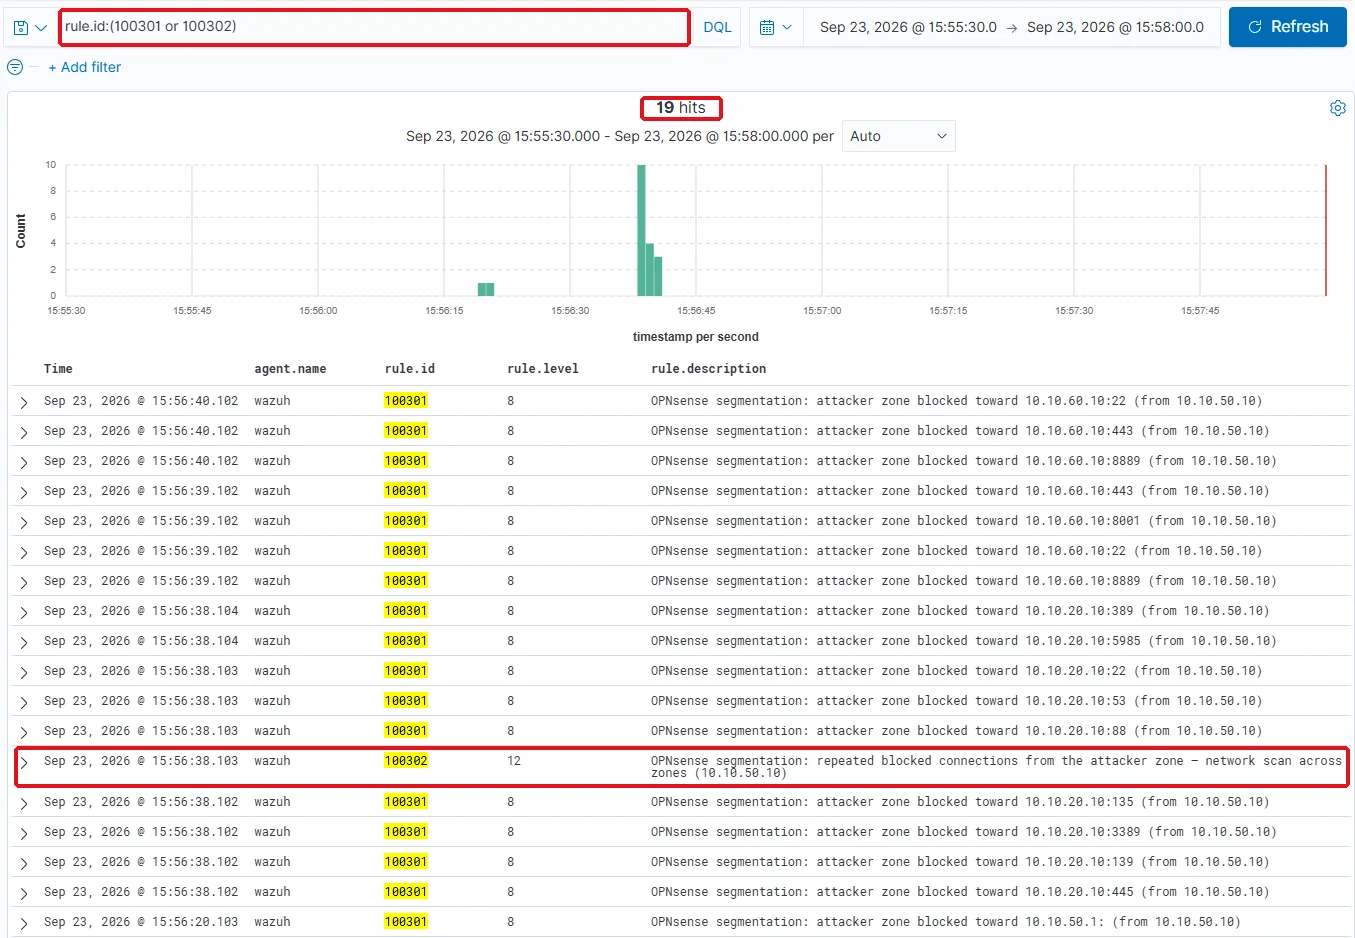
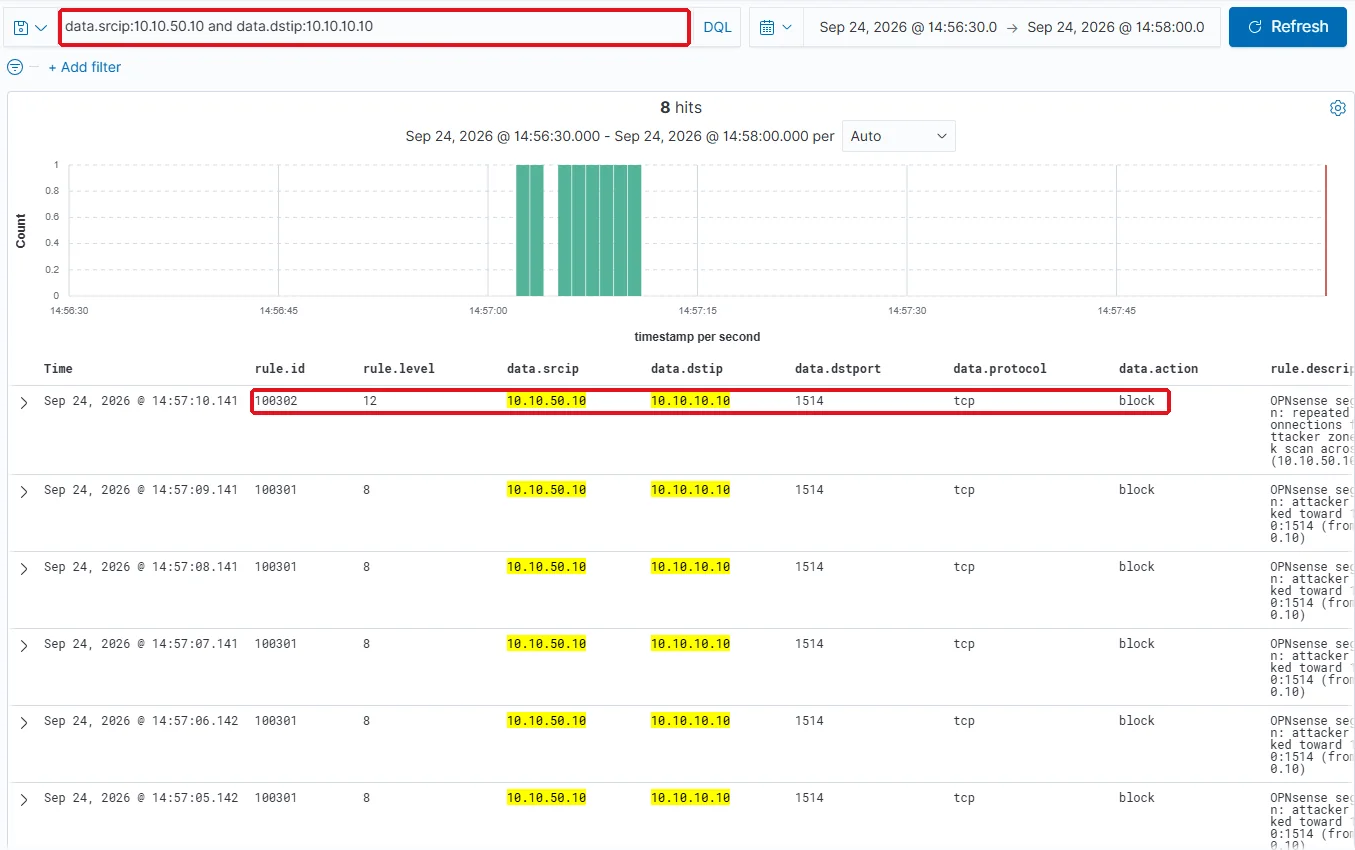
Une sonde dédiée écoute le trafic en miroir avec Suricata (52 795 signatures ET Open) et Zeek, et ses alertes remontent à Wazuh par un agent. OPNsense sépare cinq zones en refus par défaut. Toute la politique tient en 17 règles, décrites dans un fichier JSON et appliquées par l'API. Quand l'attaquant scanne les autres zones, chaque paquet rejeté donne une alerte de niveau 8 et la répétition monte au niveau 12. Quand il tente d'atteindre le manager Wazuh lui-même, chaque tentative est bloquée : l'attaquant ne peut pas joindre les outils du SOC.
Étape 4 — Automatiser la réponse, un nœud à la fois
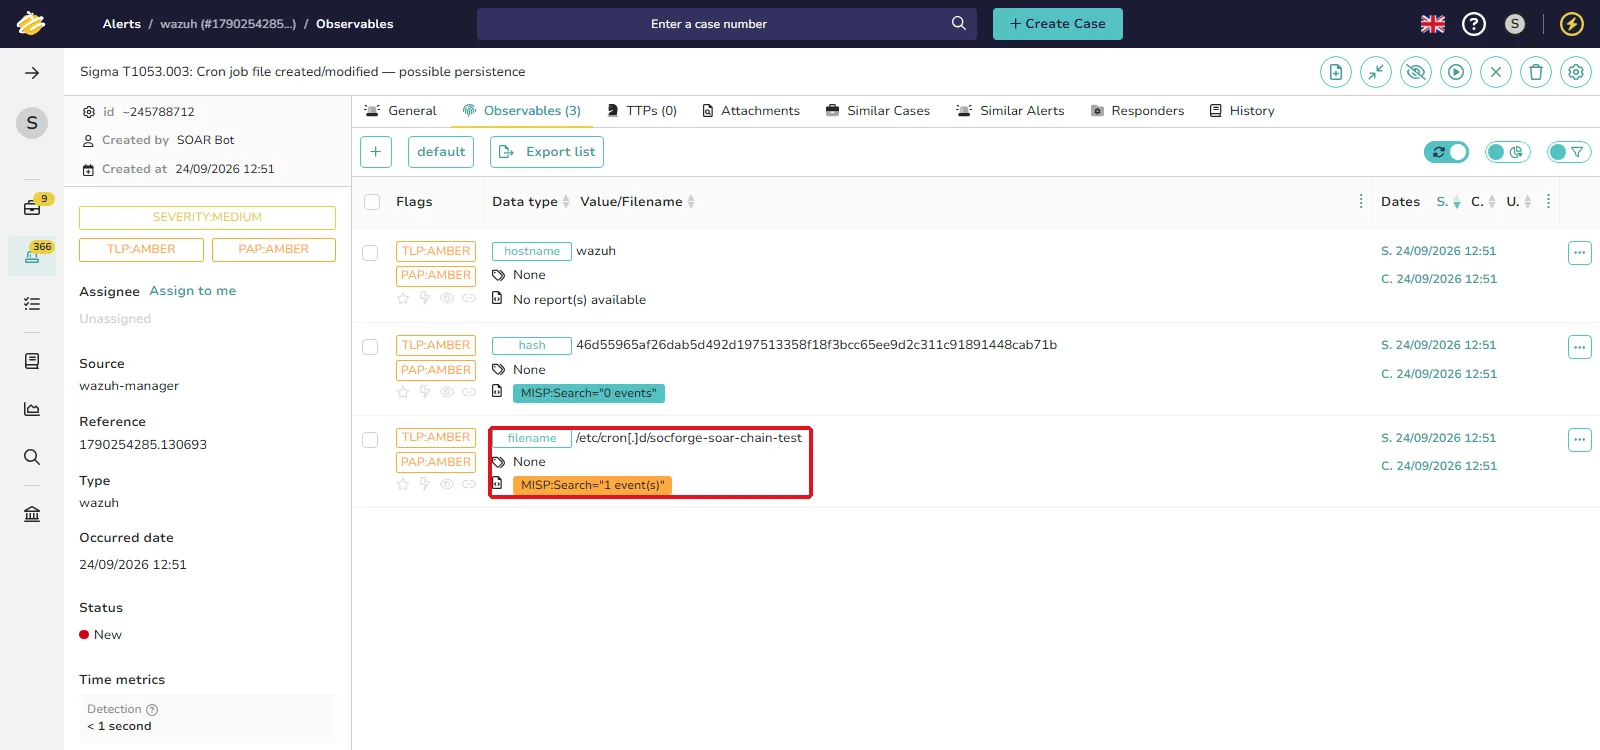
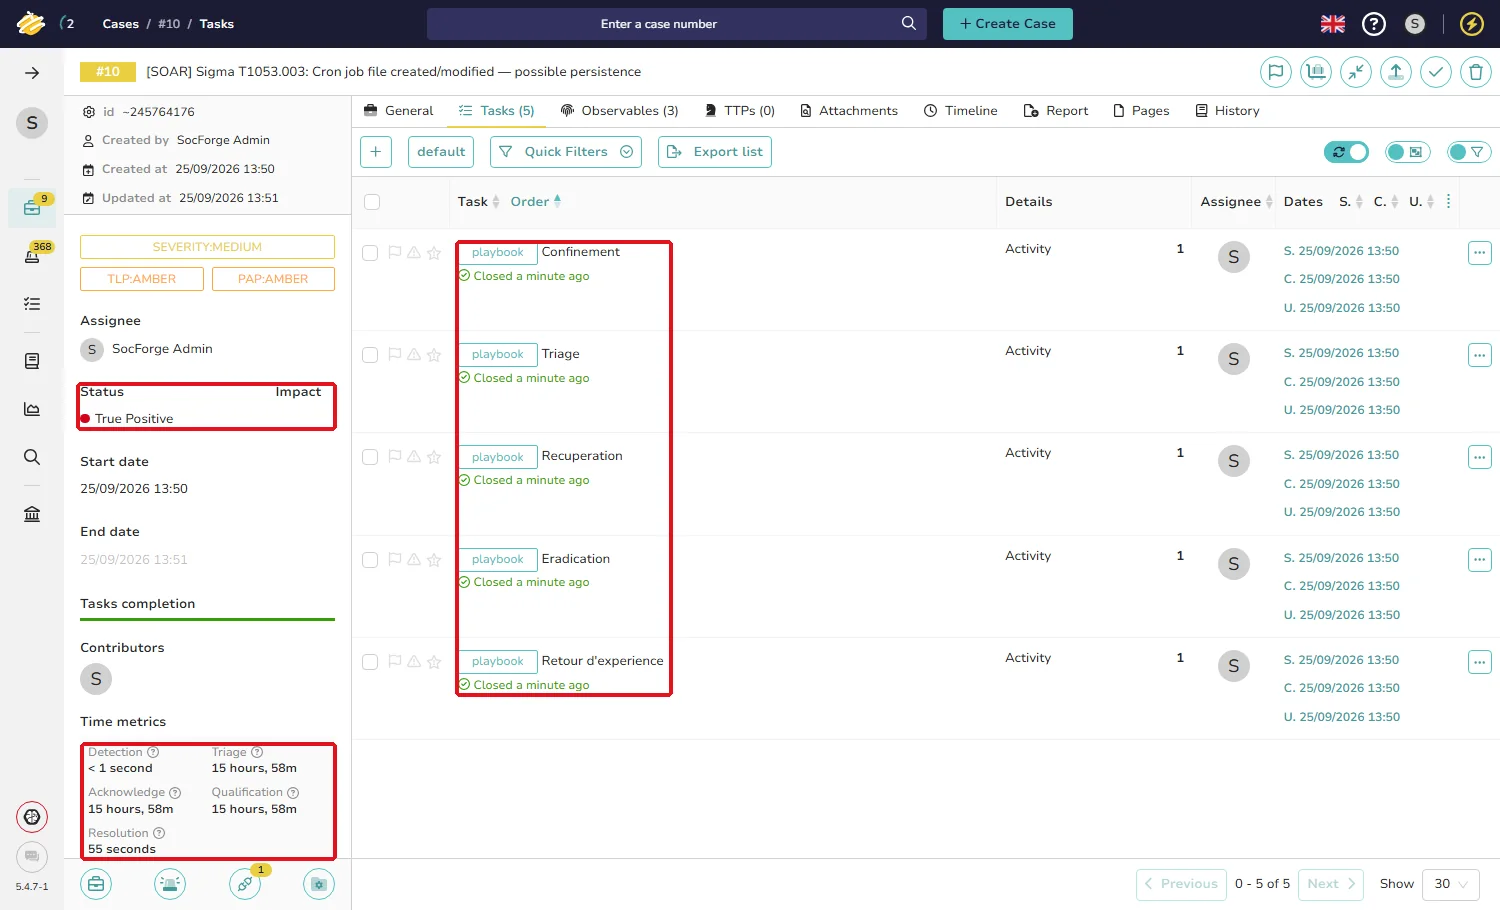
L'intégration a commencé à la main — une alerte créée dans TheHive par l'API — pour fixer le format. Puis le manager Wazuh envoie de lui-même à Shuffle toute alerte de niveau 10 ou plus. Un second workflow extrait les observables et les soumet à un analyseur Cortex qui interroge MISP. Une correspondance MISP déclenche l'étape suivante, et chaque action laisse une étiquette et une note datée sur l'alerte : tout ce que fait la chaîne se lit sur le dossier. Les alertes deviennent des dossiers traités avec un modèle en cinq tâches : triage, confinement, éradication, restauration, retour d'expérience.
Étape 5 — Chasser sur les endpoints à partir du renseignement
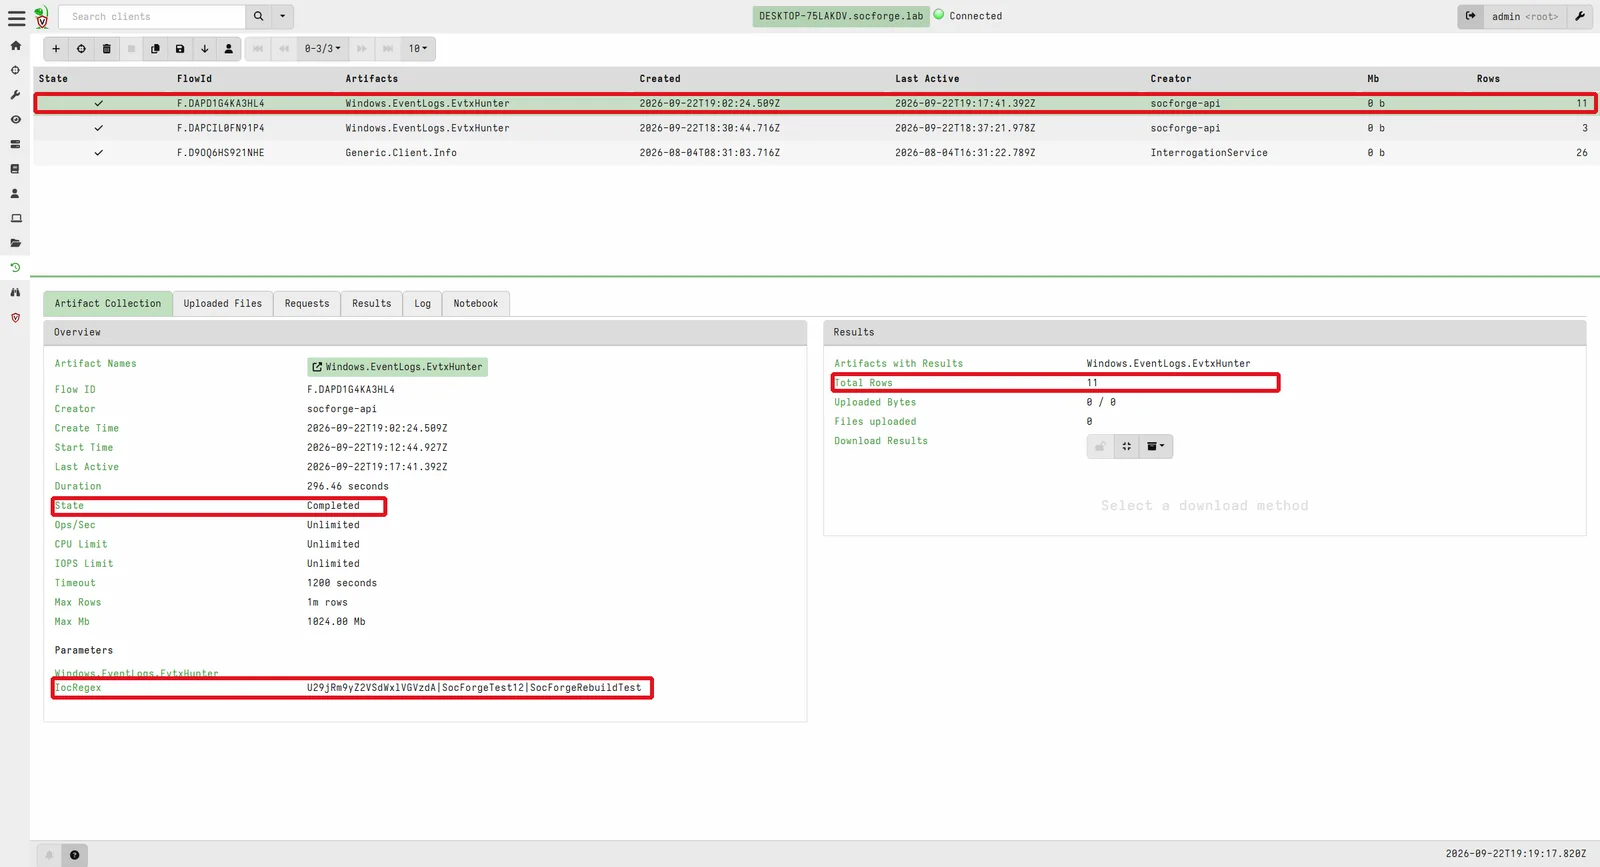
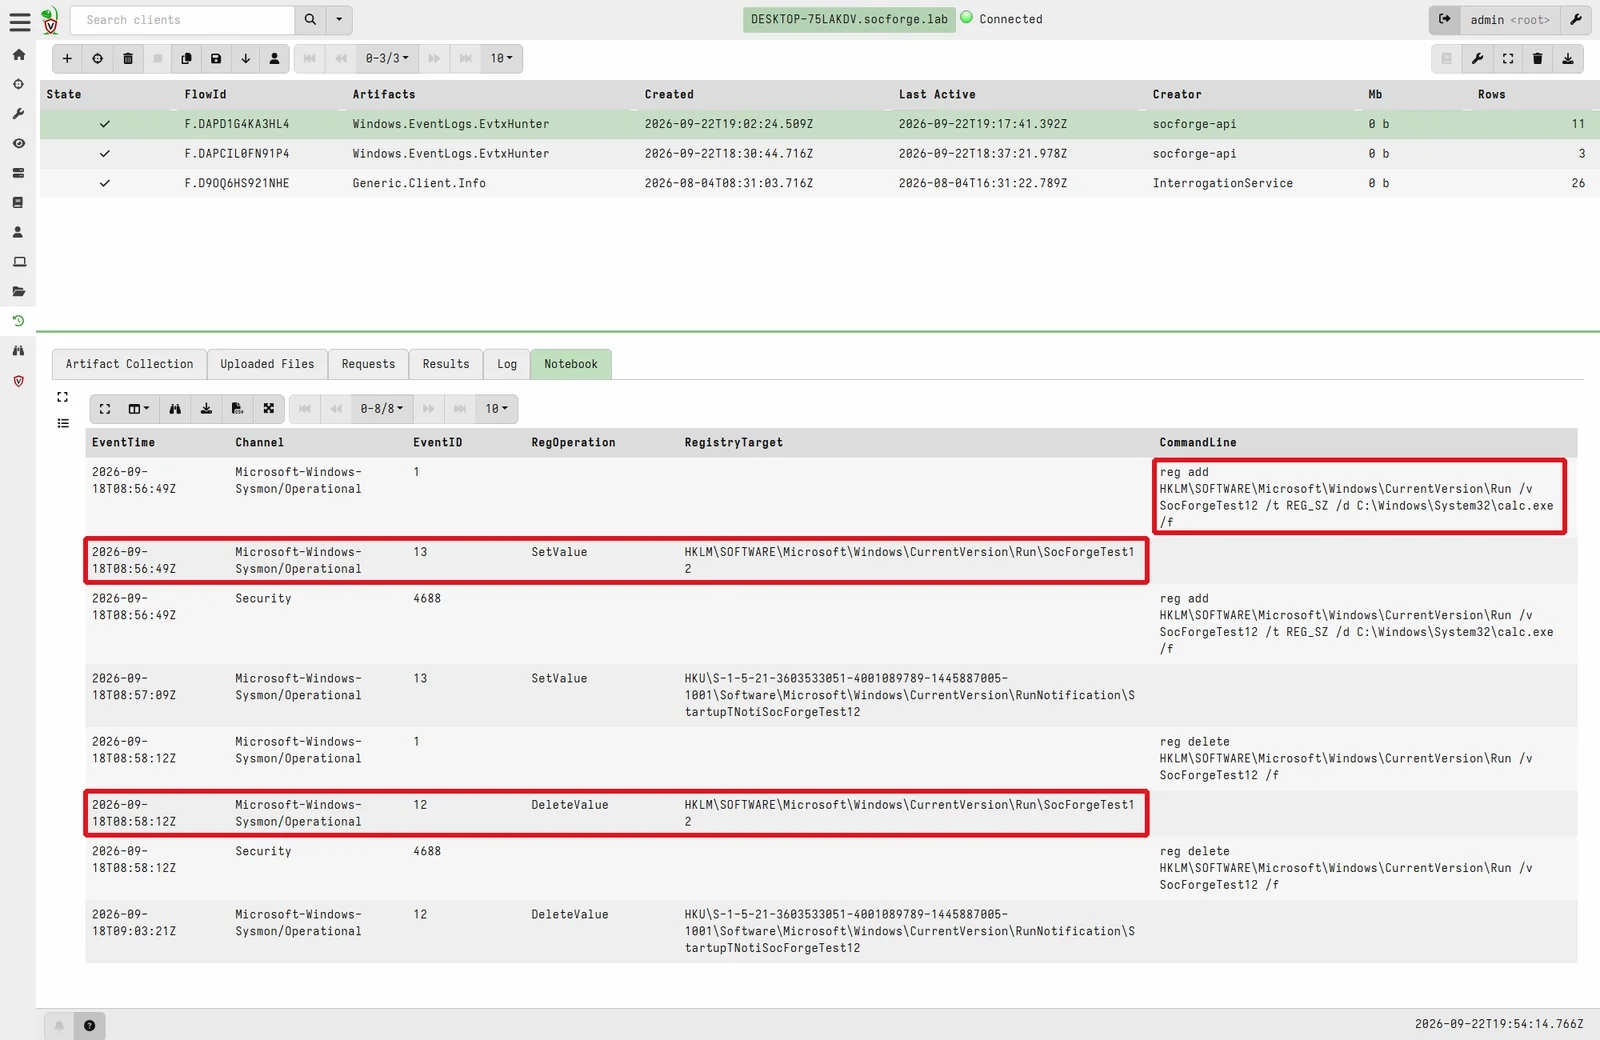
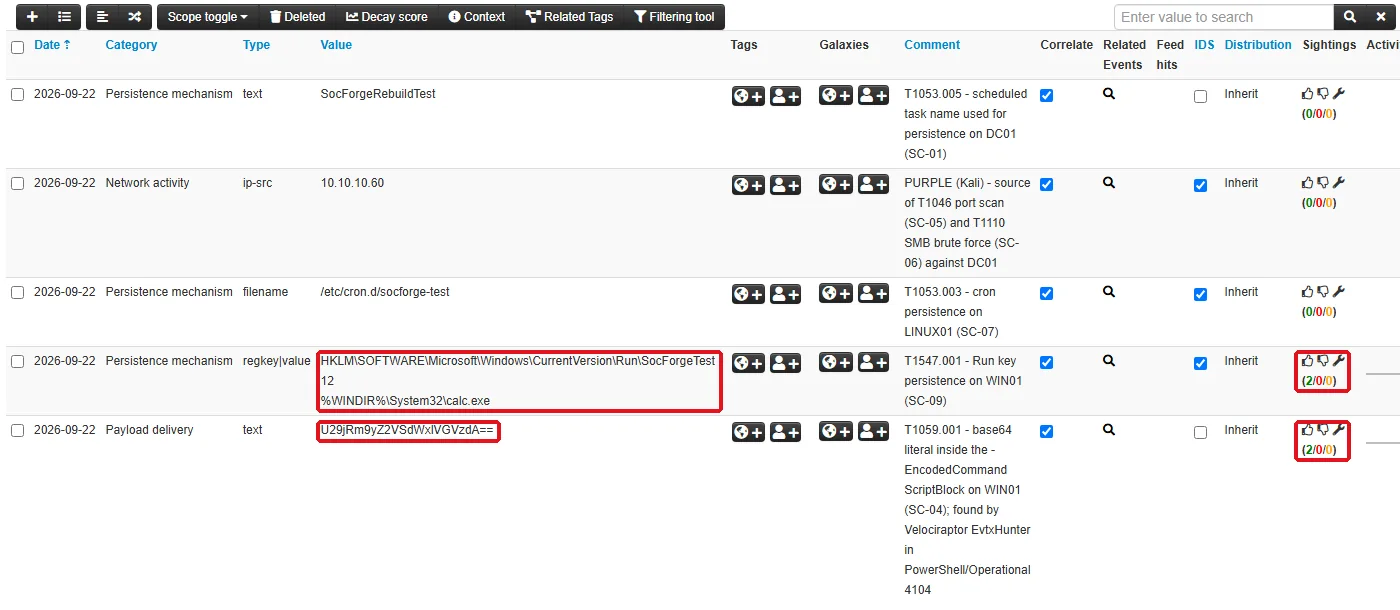
L'idée : un indicateur publié dans MISP doit suffire à lancer une recherche sur les endpoints, et le résultat doit revenir dans MISP. Un artefact serveur écrit pour le lab lit l'événement MISP et crée lui-même la chasse Velociraptor ; un second surveille la fin des chasses et envoie à MISP une observation (sighting) par indicateur trouvé. Le 7 octobre, la boucle a été rejouée sous Linux : événement MISP publié à 14:09:00, chasse créée 8 secondes plus tard sans intervention, observation de retour dans MISP 47 secondes après la publication.
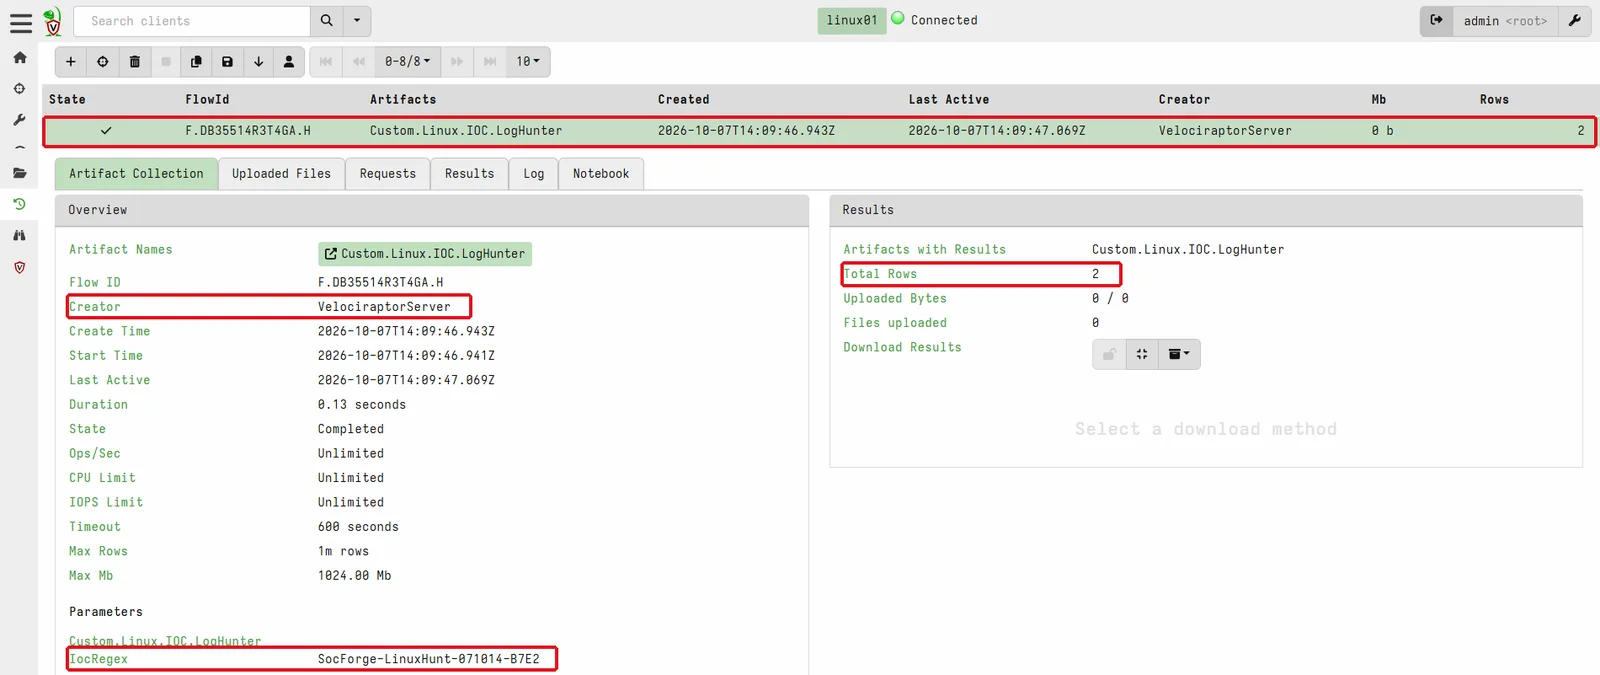
Étape 6 — Les preuves derrière les 35 secondes
Les sept captures ci-dessous proviennent toutes de l'exécution du 7 octobre. Après l'exercice, l'isolement de WIN01 a été levé et l'adresse retirée de l'alias du pare-feu.
Garde-fous de la réponse automatisée
Une automatisation capable de bloquer une adresse et d'isoler un hôte a besoin de limites qui ne reposent pas sur la vigilance de quelqu'un. Elles sont testées dans la fiche SC-14 :
- Une liste d'adresses qui ne sont jamais bloquées.
- Une étiquette qui protège le contrôleur de domaine de l'isolement.
- Un blocage limité dans le temps, levé par un workflow planifié.
- Un webhook réservé à Wazuh.
- Un accès à Velociraptor par une clé SSH restreinte à une seule commande.
- Des services HTTPS (MISP, OPNsense) appelés avec l'autorité de certification interne du lab, sans désactiver la vérification.
Ce que j'ai appris
- Une règle qui se charge n'est pas une règle qui se déclenche. La règle de la clé Run était syntaxiquement valide et muette. Seule une action réelle a révélé l'erreur de chaînage.
- Le bruit est un résultat. Seize fausses alertes sur dix-huit ne sont pas une gêne à cacher ; c'est la mesure qui a justifié une nouvelle règle.
- La réponse automatisée est une question de gouvernance avant d'être technique. Décider ce qui ne doit jamais être bloqué a demandé plus de réflexion que d'écrire le nœud qui bloque.
- Les contraintes doivent être écrites. Un hôte de 16 Go a imposé une séquence découpée ; le dire est ce qui rend les temps crédibles.
Le dépôt contient les 29 règles Wazuh, 15 règles Sigma validées en CI, la politique du pare-feu, le code des nœuds Shuffle, les artefacts Velociraptor, un rapport d'incident rédigé à partir d'une alerte réelle et les 47 captures. Première construction du 2 au 15 août 2026 ; reconstruction et audit du 13 septembre au 7 octobre 2026.